Quando o assunto é inteligência artificial, o custo alto de GPU e a falta de disponibilidade no mercado aparecem logo no início da conversa. A pergunta que interessa a quem decide é outra: o que os Transformers, a tecnologia por trás do ChatGPT, podem fazer pelos modelos clássicos que já sustentam o resultado da empresa? A resposta é que eles podem entrar nessa história sem que ninguém precise trocar os modelos que já dão lucro.
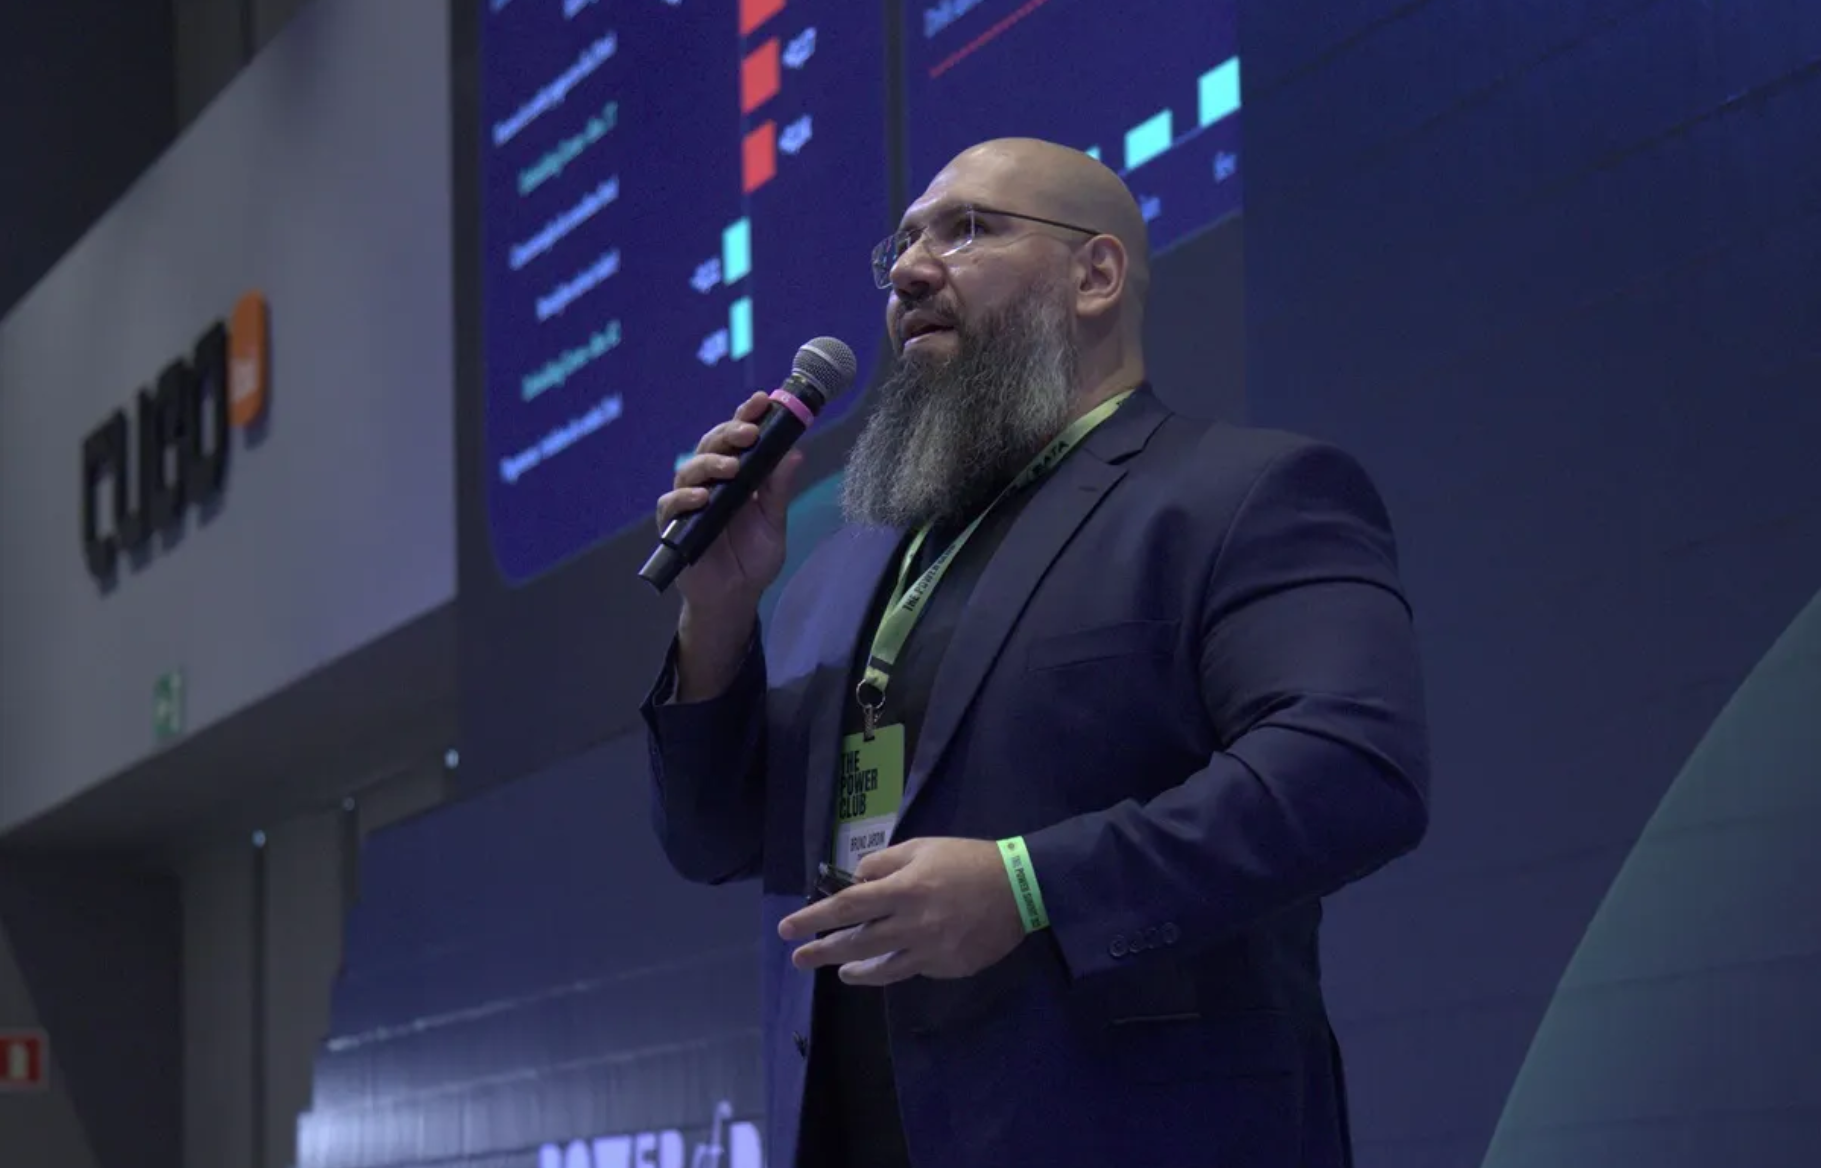
“O dado não mudou. Mudou a maneira de representá-lo”, afirma Bruno Jardim, CTO e cofundador da PowerOfData.
O que os modelos atuais deixam de enxergar
Modelos de crédito, fraude ou churn costumam ser bons, e muitos dão lucro há anos. Mas eles têm dois pontos cegos.
O primeiro está no formato. A regressão logística resolveu muitos problemas dentro dos bancos, mas separa o mundo com uma reta. Uma transação de madrugada pode ser fraude, ou pode ser um cliente que sempre usou o celular à noite, e o sinal está na combinação dos fatores.
O segundo está no tempo. Na maioria das operações, o dado tem ordem: cada evento aconteceu depois de uns e antes de outros, e essa sequência conta a história do cliente. Para prever uma fraude, um atraso de fatura ou a quebra de um motor, o histórico costuma ser espremido em médias dos últimos 3, 6 ou 9 meses. Dois clientes com trajetórias muito diferentes, um estável o ano inteiro e outro que renegocia dívida, entra no cheque especial e atrasa a fatura, podem parecer iguais para uma média. As redes neurais passaram a ler os eventos em sequência, mas as mais avançadas da época esqueciam o começo da história quando ela ficava longa demais.
Por que a conta de infraestrutura trava os projetos
Diante disso, a reação comum é propor um modelo fundacional, como fazem as Big Techs. Aí surge a dependência de infraestrutura cara. O histórico de transações de um cliente chega fácil a 8.000 eventos, e, no processamento tradicional, dobrar o histórico não dobra o custo: ele quadruplica. Só para alugar GPU em nuvem, a ordem de grandeza é de R$ 300 mil a R$ 400 mil por mês, e são necessárias várias. Justificar esse gasto na diretoria antes de provar o retorno é o que faz muitos projetos não saírem do papel.
Toda sequência de eventos é uma frase
Em 2017, pesquisadores do Google publicaram o artigo “Attention Is All You Need”, que deu origem à arquitetura dos Transformers. Dois pontos dessa virada ajudam a olhar para a operação. O primeiro é que uma frase não precisa ser texto em português: é qualquer sequência de eventos no tempo. “O cliente trocou de celular, mudou o e-mail e fez um PIX às 3h da manhã” é uma frase. A evolução das plaquetas em seis exames de sangue também. O segundo é que o mecanismo de atenção faz cada evento conversar com todos os outros ao mesmo tempo, em vez de olhar só para o passo anterior.
Em 2025, Nubank e FICO mostraram na prática que a mesma lógica de contexto funciona em dados transacionais. Uma compra de R$ 127,50 no Mercado Central entra na rede neural como uma peça de contexto rica em detalhes: sinal negativo, faixa de valor, dia da semana, tipo de estabelecimento. O Transformer lê a jornada inteira do cliente e entrega um resumo comportamental denso, o chamado embedding.
“Você não joga fora os modelos de risco que a sua equipe já construiu e que dão lucro hoje”, destaca Bruno. A regressão logística, o XGBoost e o LightGBM continuam no jogo, e o embedding entra como mais uma variável explicativa, ao lado do book de variáveis atual, sem mudar a forma como o time analisa e monitora o score. O mesmo vale para classificação, regressão e recomendação de oferta, e para qualquer entidade que gere eventos no tempo, seja uma pessoa num banco, um paciente num hospital ou um motor numa indústria.
O que muda quando a empresa treina o próprio Transformer
Ao treinar um Transformer próprio, a PowerOfData buscou resolver os dois medos que travam a decisão: a conta de infraestrutura na nuvem e o risco de colocar um algoritmo sem explicação em produção. O resultado é o PoD Cortex.
Em custo computacional, a arquitetura foi otimizada para que o processamento deixasse de crescer de forma quadrática e passasse a crescer de forma linear. Na prática, é possível rodar modelos fundacionais lendo milhares de transações sem depender de uma estrutura de GPUs na escala das Big Techs, e o ROI do projeto se sustenta.
Em governança, o contexto comportamental do cliente entra no modelo lado a lado com as variáveis clássicas que a equipe já conhece, como o status da fatura do mês. Segundo Bruno, não há a interpretabilidade de uma regressão logística pura, mas existe explicabilidade suficiente para acompanhar o que puxa o score para cima ou para baixo, mantendo a ordenação de risco e a estabilidade ao longo do tempo (as chamadas safras) que o compliance exige.
Em retorno financeiro, quem trabalha com crédito, prevenção à fraude ou cobrança sabe que subir 2 ou 3 pontos de KS em um modelo já significa muito dinheiro na mesa. Nos testes em modelos de classificação no segmento financeiro, o incremento de KS e Gini aparece de forma recorrente.
Um ponto que Bruno faz questão de repetir: nenhum Transformer resolve dado desorganizado. Antes do modelo vem a Fundação, ou seja, a maturidade dos dados e, muitas vezes, a maturidade da organização para decidir com eles.
Sobre o autor
Bruno Jardim é CTO e cofundador da PowerOfData, ecossistema completo de inteligência aplicada que integra tecnologia proprietária em dados e IA, execução especializada e formação de talentos para transformar dados em decisões e resultados reais.


